



Жизненный цикл инцидента информационной безопасности: от обнаружения до извлечения уроков
Системный подход к реагированию сокращает ущерб от кибератаки и превращает инцидент в повод усилить защиту. Разбираем этапы жизненного цикла, роли в команде и типичные ошибки.
Кибератака на корпоративную ИТ-инфраструктуру представляет собой, как правило, совокупность действий, включающих в себя различные этапы: разведка ресурсов цели, получение первоначального доступа, повышение привилегий, закрепление в инфраструктуре и т. п., и, конечно же, попытки достижения преследуемых целей злоумышленниками. Отсутствие системного подхода к выявлению кибератаки и реагированию на инцидент информационной безопасности, превращает все корпоративные процессы в неуправляемый кризис: решения принимаются хаотично, ущерб растёт, а команда действует «наугад».
Системный подход к реагированию, с заранее определёнными ролями, коммуникационными каналами и процедурами эскалации – позволяет не только сократить финансовый и репутационный ущерб, как правило, за счет раннего обнаружения развивающегося инцидента и недопущения деструктивных последствий, но и использовать его для повышения защищённости компании, извлекая уроки из проблем с минимальным, либо отсутствующим ущербом. По практике Лаборатории цифровой криминалистики и исследования вредоносного кода F6 80% инцидентов связаны именно с программами-вымогателями. Подобные атаки затрагивают представителей бизнесов всех размеров, в том числе крупные корпорации: в 2025 году количество атак программ-вымогателей на российские компании выросло на 15% по сравнению с 2024 годом, а в первом полугодии 2026 по отношению к тому же периоду 2025 года количество деструктивных атак снизилось на 20%. Первоначальные требования вымогателей для крупного бизнеса в 2025 году достигали 430 млн рублей, для малого и среднего бизнеса: 4 млн рублей, в 2026 суммы выкупа изменились незначительно – 320 млн и 4 млн соответственно. Однако стоит заметить, что снижение суммы выкупа обусловлено не снижением аппетитов злоумышленников, а, прежде всего, криптовалютным курсом на момент требования выкупа. Кроме того, требования вымогателей не единственная проблема, с которой сталкиваются представители различных бизнесов, очередными проблемами после разрушительной атаки являются убытки от простоя в период восстановления работоспособности компании и упущенная прибыль, претензии от партнеров и регуляторов. Поэтому наличие заранее подготовленного плана реагирования становится не просто рекомендацией, а необходимым элементом устойчивости бизнеса.
Почему процесс реагирования на инциденты информационной безопасности требует системного подхода
Инцидент информационной безопасности представляет собой событие, которое нарушает конфиденциальность, целостность или доступность информационных активов компании, это может быть как фишинговая рассылка, так и атака шифровальщика. Масштаб угроз различен, но принцип действий один: чем быстрее организация проходит путь от обнаружения угрозы до полного восстановления работоспособности, тем меньше ее потери.
Ключевая проблема большинства организаций заключается в отсутствии формализованного процесса. Служба ИБ действует интуитивно, разные команды работают несогласованно, а решения принимаются в условиях паники и отсутствия регламентов по управлению инцидентами ИБ. В результате время простоя растягивается на дни, а иногда и недели, хотя технически угроза могла быть локализована за несколько часов. Ситуацию обостряет рост угроз. Аналитики F6 зафиксировали в 2025 году активность 27 прогосударственных хакерских группировок, нацеленных на Россию и страны СНГ. Рост числа подобных угроз означает, что компаниям не стоит полагаться на разовые меры защиты, необходим системный подход к обеспечению безопасности: постоянный мониторинг и заранее выстроенные процессы реагирования.
Системный подход заменяет хаотичные реакции при выявлении инцидента – управляемым процессом, в котором за каждой задачей закреплен ответственный, решения принимаются по заранее утверждённым критериям, а эффективность измеряется различными метриками. Крупные организации всё чаще выстраивают эту работу на базе центра мониторинга и реагирования.
Этапы реагирования на инциденты информационной безопасности: от теории к практике
Несмотря на различия в структуре, терминологии и регуляторном контексте стандартов NIST SP 800-61, ISO/IEC 27035 и ГОСТ Р 59712-2022, они базируются на едином концептуальном фундаменте, который отвергает представление о реагировании как о наборе разовых героических действий. Управление инцидентами определяется как непрерывный, воспроизводимый, документированный процесс с чёткими входами, выходами, ролями и метриками, характеризующими время обнаружения инцидента (MTTD – Mean time to Detect), время подтверждения (MTTA – Mean Time to Acknowledge), время реагирования/восстановления (MTTR – Mean time to Respond/Recover) и другие. Хаотичная импровизация рассматривается всеми стандартами как антипаттерн.
Чтобы исключить этот антипаттерн и превратить теорию в работающий механизм, индустрия выработала универсальный жизненный цикл инцидента. Независимо от того, какой именно стандарт ляжет в основу вашей корпоративной политики, путь от первого подозрительного алерта до полного возврата к штатной работе всегда проходит через одни и те же этапы: подготовка, обнаружение и анализ, сдерживание, локализация, устранение последствий и восстановление, извлечение уроков.
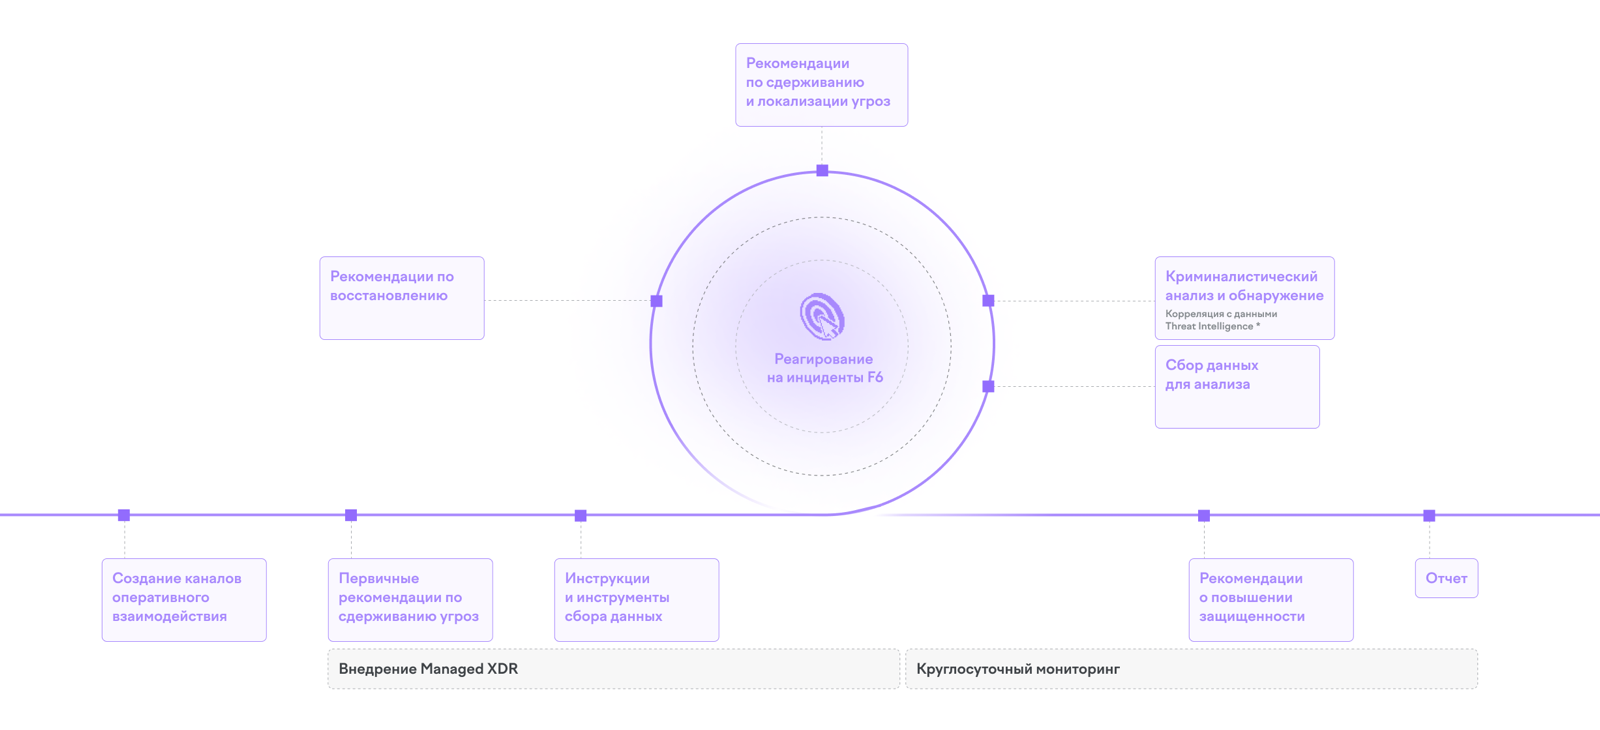
Бывает, что в кризисных ситуациях компаниям не хватает рук или у них отсутствуют процессы и компетенции в реагировании, тогда им достаточно обратиться к команде экспертов Лаборатории цифровой криминалистики и исследования вредоносного кода нашей компании. Более чем 20-летний опыт реагирований на различные кибератаки позволяет экспертам оперативно встроиться в процессы любой компании, взять ситуацию под контроль, и выбить хакеров из инфраструктуры. Ниже показано, как этапы аутсорс-реагирования на инциденты Лаборатории выглядят на практике:
Зачастую при обращении в лабораторию у клиента уже имеются либо некоторые признаки неправомерного доступа, либо явные признаки инцидента ИБ. Запросив релевантные сведения, специалисты F6 классифицируют характер угрозы, степень ее критичности и потенциальный масштаб проблем, который стоит перед клиентом. На основании этих данных эксперты лаборатории предоставляют клиенту первичные технические рекомендации по сдерживанию угроз и разрабатывают план действий по реагированию на них и дальнейшему расследованию. Оценка позволяет верно расставить приоритеты в дальнейших действиях и обеспечить кратчайший путь к безопасному восстановлению работоспособности инфраструктуры после кибератаки.
Проведя оценку, специалисты по реагированию определяют необходимые для реагирования и выявления обстоятельств инцидента источники криминалистически значимой информации и предоставляют все необходимые инструкции и инструменты для сбора данных из них. Специалистами лаборатории используется большое количество авторских программ, утилит и скриптов, которые позволяют быстро собирать и восстанавливать необходимую для реагирования информацию с устройств любой корпоративной инфраструктуры. Собранные данные передаются по защищенному каналу связи в наше корпоративное облачное решение, а затем анализируется специалистами в изолированной среде.
Специалисты по реагированию оперативно изучают собранные данные, чтобы выявить инструменты, тактики, техники и процедуры атакующих, и провести реконструкцию инцидента для обнаружения точки первоначальной компрометации. На основе этого анализа выявляются индикаторы компрометации, а также разрабатывают и предоставляют рекомендации по локализации выявленных угроз, меры противодействия дальнейшему или повторному развитию атаки.
Пока идёт реагирование, опционально предлагаем клиентам пилотный проект нашего продукта MXDR, благодаря которому инфраструктура клиента переходит под непрерывный круглосуточный мониторинг системной и пользовательской активности. Это можно реализовать двумя способами: через платформу F6 MXDR, которую команда клиента разворачивает и использует самостоятельно, либо через сервис SOC MDR от Центра кибербезопасности F6, если компании нужна помощь внешней команды на аутсорсе. При обнаружении новых угроз мы уведомляем клиента о них и, при наличии договоренностей, предпринимаем меры по их локализации.
На основе собранной телеметрии и анализа действий злоумышленников специалисты по реагированию формируют точечные рекомендации по повышению уровня защищённости инфраструктуры и предотвращению подобных атак в будущем. Рекомендации закрывают не только последствия случившегося, но и его первопричину: слабые места в архитектуре, процессах и настройках безопасности и т.п.
Когда угрозы локализованы, выявлены все обстоятельства инцидента ИБ, специалисты готовят отчёт с подробной хронологией атаки, анализом обнаруженного инструментария злоумышленников и рекомендациями по повышению уровня защищенности. Этот документ становится основой для того самого этапа извлечения уроков, о котором говорится в названии этой статьи.
Схематично реагирование на инциденты выглядит так:
Управление инцидентами информационной безопасности: роли, процессы и зрелость
Эффективная работа над такими случаями невозможна без чёткого распределения ролей. В зрелой модели участвуют:
- Директор по ИБ: координирует действия и принимает ключевые решения.
- Аналитики SOC: отвечают за детектирование и первичный анализ алертов.
- Специалисты по реагированию и цифровой криминалистике: восстанавливают хронологию событий, собирают криминалистические артефакты.
- IT-команда: выполняет действия по изоляции и восстановлению систем.
- Юридический и PR-блок: оценивают обязательства перед регуляторами и клиентами.
- Руководство компании: принимает решения о ресурсах и остановке бизнес-процессов.
Зрелость данной практики оценивается по нескольким ключевым параметрам: наличие утверждённых планов действий, чётко прописанные должностные инструкции для каждой роли в момент реагирования, регулярная отработка сценариев атак специалистами, скорость реакции, полнота итоговой документации, а также качество настройки средств защиты и мониторинга киберугроз.
Многие компании вкладывают значительные средства в SIEM и EDR, но забывают выстроить процессы вокруг этих инструментов. Технологии закуплены, а согласованного алгоритма действий команды при реальном вторжении не существует.
Именно зрелость такого подхода отличает организации с низким MTTR от тех, где расследование растягивается на месяцы.
Отдельным источником зрелости служит постоянный мониторинг угроз силами собственного или внешнего центра мониторинга безопасности.
Типичные ошибки при реагировании на инциденты информационной безопасности
Исходя из опыта реагирований, даже в компаниях с развитой ИБ-функцией и формальным подходом к реагированию повторяются одни и те же ошибки:
- Отсутствие актуального плана реагирования. Документ существует формально, но не обновляется в соответствии с изменениями в: инфраструктуре, актуальном ландшафте угроз и не проверяется на учениях с имитациями действий атакующих.
- Задержка в эскалации. Специалист или сотрудник, обнаруживший аномалию первым, не знает, кому сообщать, из-за чего информация доходит до нужных людей с опозданием на часы.
- Уничтожение цифровых доказательств. Поспешная переустановка систем лишает специалистов возможности восстановить вектор вторжения и оценить масштаб компрометации.
- Восстановление без устранения причины. Системы возвращаются в работу до того, как закрыт исходный вектор проникновения, что открывает путь для повторного вторжения.
- Игнорирование анализа для установления причин компрометации. Без разбора причин компания не извлекает уроков и сохраняет риск повторения ситуации.
- Недостаток компетенций для сложных угроз. Нехватка узконаправленной экспертизы для нетиповых инцидентов. Противодействие APT, вымогательству и атакам через цепочку поставок предполагает специфические навыки, которые сложно закрыть внутренними ресурсами.
Как выстроить эффективный процесс управления инцидентами: практические шаги
Построение зрелой системы реагирования требует трёх составляющих: формализованных процедур, обученных специалистов и настроенных средств защиты информации, помимо этого в идеале необходим доступ к экспертизе для инцидентов с высоким уровнем сложности.
Чек-лист: оценка зрелости процесса
- Существует актуальный план действий на случай нештатной ситуации, обновлённый в последние 12 месяцев и соответствующий ландшафту угроз, применимого для сферы деятельности компании
- Роли и зоны ответственности команды распределены и задокументированы
- Настроен непрерывный мониторинг инфраструктуры в режиме 24/7
- Есть отработанный канал эскалации инцидента независимо от времени суток
- Резервные копии регулярно тестируются на восстановление и не имеют сетевой связанности с инфраструктурой
- Регулярно проводятся услуги по оценке защищенности, такие как Red Teaming и Purple Teaming для оттачивания навыков команды защищающихся
- Определён порядок привлечения внешней экспертизы для инцидентов, выходящих за рамки внутренних компетенций
- Каждый инцидент завершается разбором причин его наступления и обновлением регламентов, и настройкой СЗИ для повышения уровня защищенности информационной безопасности
Если хотя бы половина пунктов не выполняются, компании стоит обратить внимание на существующие процессы ИБ и по возможности пересмотреть их, до возможной атаки на компанию, для снижения рисков, угроз и потенциального ущерба.
Каждый инцидент: либо потерянное время, либо усиленная защита
Компании, которые проходят через полный жизненный цикл инцидента информационной безопасности, от обнаружения до полного восстановления работоспособности, выходят из ситуации с более зрелой защитой. Те, кто пропускает этапы анализа данных по событию, восстановление хронологии развития атаки, рискуют столкнуться с повторным наступлением аналогичного прецедента.


